
Depuis le temps que j'en rêvais, j'ai fini par le faire...
Match ANF data est un outil qui permet d'explorer rapidement des centaines de milliers de données nominatives historiques, de constituer des corpus de recherche et de croiser une liste personnelle d'individus avec des milliers noms pour obtenir des correspondances pertinentes. Le tout sans être obligé de déposer ses données sur un site commercial fermé.
Bref, une version simplifiée et sur des données patrimoniales de ce qu'on peut faire avec deces.matchid.io (dont je suis fan et grande utilisatrice) pour les fichiers de décès de l'INSEE.
L'outil donne accès à plus d'1 million (pour l'instant) de données nominatives historiques ouvertes issues des inventaires des Archives nationales.
L'onglet Explorer permet d'interroger les différents champs : nom, prénoms, date de naissance, genre, période, etc.
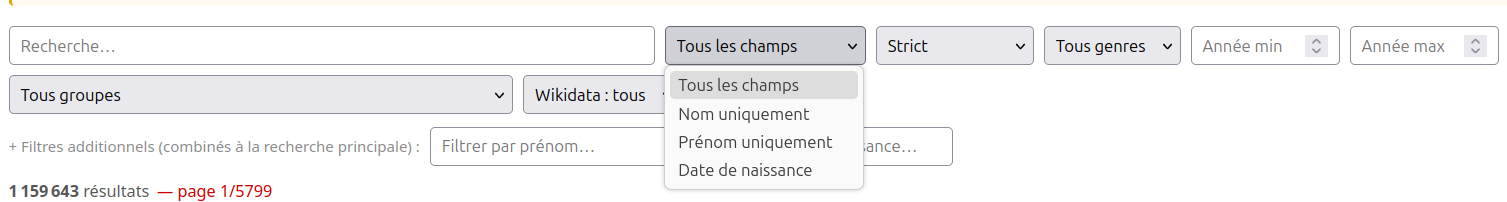
- de manière stricte (comme on le fait habituellement) ;
- de manière floue, pour exemple pour pallier aux variations orthographiques, aux coquilles de l'administration qui a géré ces dossiers (voire des archivistes) ;
- en utilisant des expressions régulières (regex) ; exemples : des noms finissant par ian : ian$ ; des noms en 3 parties courtes : ^([a-z]{1,4}) ([a-z]{1,4}) ([a-z]{1,4})$ ou encore des dates de naissance commençant par 18... : ^18. Voir aussi le tutoriel sur les expressions régulières.
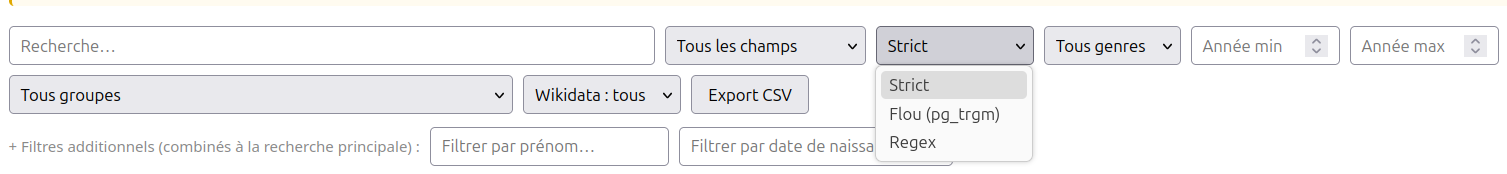
Un champ de recherche secondaire permet de filtrer les premiers résultats de recherche obtenus. Il est possible, pour une partie des données, de définir une période historique en utilisant une année minimum et une année maximum de recherche.
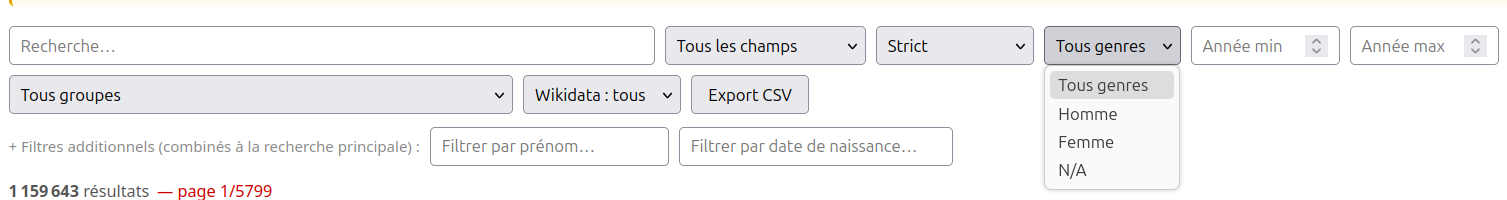
Les recherches peuvent être filtrées par genre, par groupe de données ou encore par l'indication d'un identifiant Wikidata. Les colonnes sont triables en cliquant sur les intitulés. Le tout est exportable en CSV, avec dans le fichier exporté, les cotes des dossiers et le permalien vers les notices descriptives.
L'onglet Appariement permet d'envoyer ses propres données nominatives (fichier csv avec des colonnes nom, prenom, date de naissance le cas échéant) pour les croiser avec tout ou partie de la base de données, en choisissant le type d'appariement et le taux de pertinence choisi.
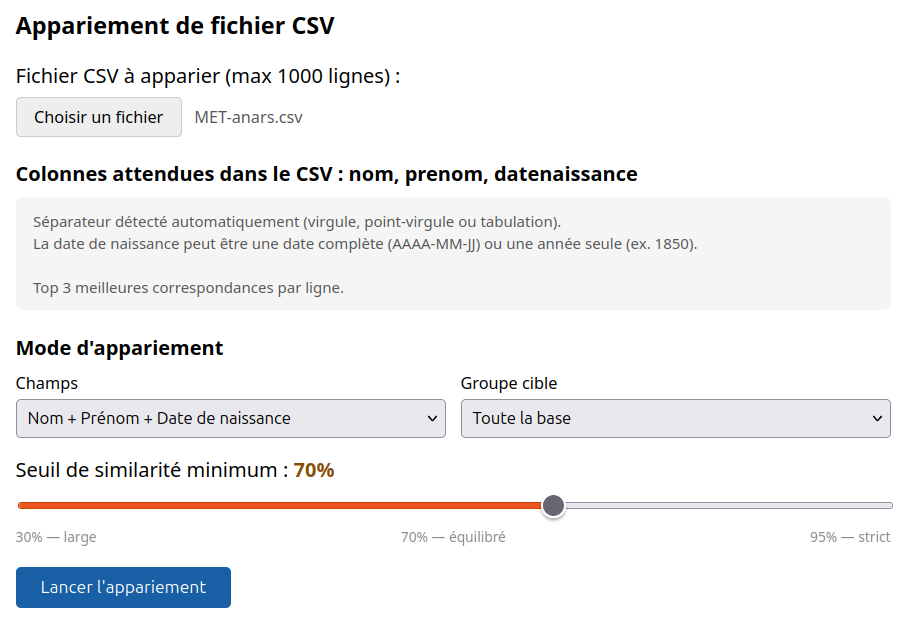
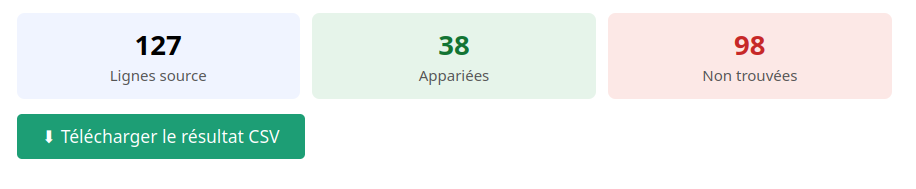
En testant avec une petite liste d'anarchistes français* avec date de naissance, on obtient 38 correspondances possibles (dans le Fichier central de la Sûreté comme escompté, mais aussi dans les imprimeurs, libraires et lithographes).
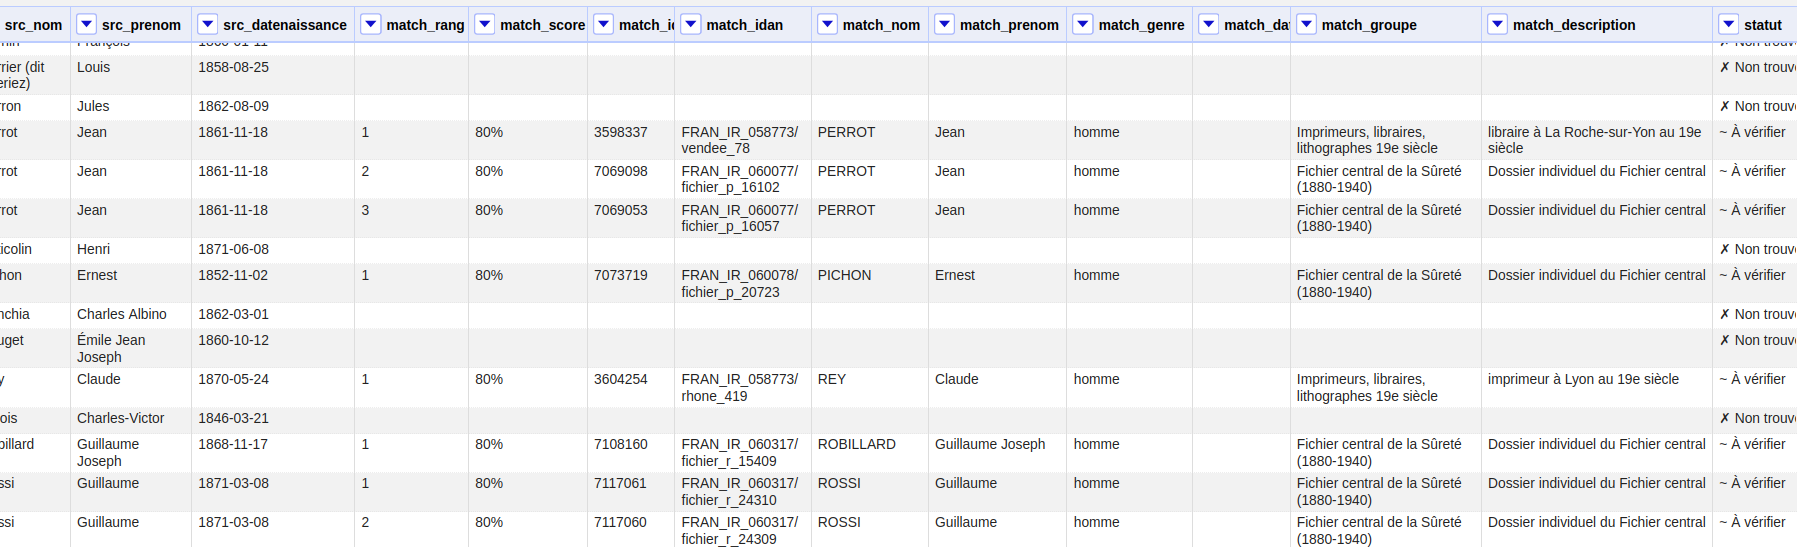
Le résultat de l'appariement est téléchargeable au format CSV, avec les données d'origine, auxquelles s'ajoutent de nouvelles colonnes indiquant les correspondances possibles, leur taux de fiabilité et les données correspondantes dans la base nominative interrogée.
Le code du prototype est accessible librement sur GitLab. L'infrastructure est déployée avec un conteneur Docker, avec une base en PostgreSQL, FastAPI, React et Caddy. Le code et son déploiement a été accompagné par Claude.ai (dans mon entourage, Python ça n'est qu'un serpent...). Tout est hébergé en France et les données ne sont pas stockées que le temps de l'appariement.
* ceux pour lesquels j'avais fait une cartographie ici il y a longtemps. La carte fonctionne toujours, les liens vers la source - le MET - 9 ans après, moins...
Pour aller plus loin
- le code de Match ANF Data sur GitLab
- les données ouvertes des Archives nationales
- l'icône Naturwissenschaft de Julian Kücklich, CC0, via Wikimedia Commons
- deces.matchid.io, qui permet d'explorer les fichiers de décès de l'INSEE depuis 1970 ET d'apparier ses propres données
Comments